
204 읽음
작지만 강력한 멀티모달 AI, 구글 임베딩젬마 2 등극
 IT조선
 0
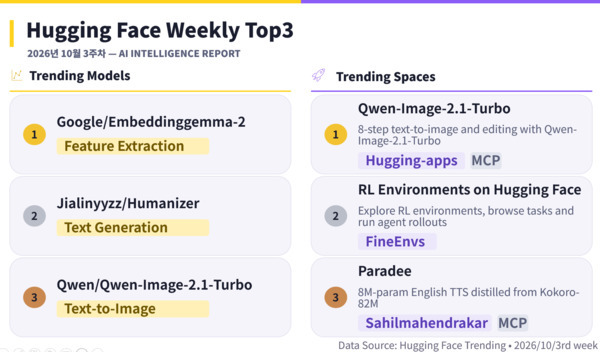
모델 쪽 첫 번째 전학생은 구글의 임베딩 모델입니다. 글, 사진, 영상, 소리를 하나의 주소 체계로 바꿔 주는데, 몸집은 10억 파라미터에도 못 미칩니다. 두 번째는 AI가 쓴 초안을 사람이 쓴 것처럼 고쳐 쓰는 120억 파라미터급 문장 다듬기 모델이고, 세 번째는 단 여덟 번의 계산으로 그림을 완성하는 이미지 모델입니다. 스페이스에서는 그 이미지 모델의 체험장, AI 에이전트의 연습장 안내소, 그리고 800만 파라미터짜리 초소형 음성 합성기가 이름을 올렸습니다.
이번 주 순위는 10월 15일 허깅페이스 모델 목록의 '트렌딩(Trending)' 정렬 상위 3개와 10월 12일 자 ‘이번 주의 스페이스(Spaces of the week)’ 상위 3개를 기준으로 했습니다. 이번 주의 키워드는 세 가지입니다. ‘작지만 넓은’, ‘사람처럼 고쳐 쓰는’, 그리고 ‘여덟 걸음’입니다. 이번 주도 퀴즈로 시작하겠습니다.
글과 코드, 사진, 영상, 소리를 모두 같은 768차원의 '주소 체계'에 담아 주는 구글의 모델입니다. 몸집은 7억4000만 파라미터인데, 글만 다룰 때는 2억7000만 파라미터 분량만 불러 쓸 수도 있습니다. 이 모델의 이름은?
8200만 파라미터 음성 합성 모델에서 '증류'해 크기를 약 10분의 1로 줄인 영어 전용 음성 합성기입니다. 800만 파라미터짜리 이 체험장의 이름은?
정답은 ‘임베딩젬마 2(EmbeddingGemma 2)’와 ‘파라디(Paradee)’입니다. 그럼 이번 주에는 어떤 혁신이 등장했는지 함께 살펴보겠습니다.
1위: google/embeddinggemma-2 | Feature Extraction
“검색창의 눈, 귀, 입이 한 권의 주소록에 모였다…7억4000만 파라미터 멀티모달 임베딩”
구글 딥마인드가 공개한 임베딩 모델입니다. '좋아요'는 2000개를 조금 넘고, 월 다운로드는 12만5000회 안팎입니다. 이번 주 트렌딩 1위입니다.
임베딩은 글이나 사진의 '뜻'을 숫자 묶음, 즉 좌표로 바꿔 주는 기술입니다. 도서관에서 책마다 청구기호를 붙이면 비슷한 주제의 책이 같은 서가에 모이듯, 뜻이 비슷한 자료는 좌표도 가까워집니다. 그래서 검색, 추천, 문서 분류의 밑바탕으로 쓰입니다. 챗GPT 같은 대화형 AI가 사내 문서를 뒤져 답할 때 먼저 필요한 자료를 찾아오는 일(RAG)도 임베딩이 맡습니다.
이 모델의 특징은 '한 주소록에 모든 자료를 담는다'는 데 있습니다. 모델 카드에 따르면 글(코드 포함), 이미지, 영상, 오디오를 하나의 768차원 공간에 놓습니다. 이전 세대가 글 전용이었다면, 이번에는 “사진으로 찾은 상품을 설명하는 글”이나 “회의 녹음에 담긴 그 이야기”를 같은 잣대로 찾을 수 있다는 뜻입니다. 100개 이상의 언어를 이해하고, 한 번에 읽는 분량은 8000토큰 남짓(8192)입니다. 오디오는 5분 남짓, 이미지는 기본 설정으로 29장 안팎을 한 번에 담을 수 있다고 합니다.
몸집이 작다는 점도 장점인데요. 전체 7억4000만 파라미터는 글 담당 2억7000만, 이미지 담당 1억7000만, 소리 담당 3억으로 이뤄진 '조립식'이라, 필요한 부품만 골라 쓸 수 있습니다. 글만 다루면 2억7000만 파라미터 분량으로 충분합니다. 구글은 스마트폰과 노트북 같은 일반 기기에서 돌리는 것을 염두에 뒀다고 설명합니다.
성적표는 구글의 자체 측정입니다. 다국어 글 임베딩 시험(MTEB)에서는 61.36점으로 이전 세대(61.15점)와 사실상 비슷하지만, 코드 검색에서는 68.76점에서 78.68점으로 크게 올랐다고 합니다. 한편 한국어에 대한 별도 성적은 모델 카드에서 찾지 못했습니다. 카드도 언어마다 성능이 같지는 않을 수 있다고 밝혔으니, 국내 도입을 검토한면 우리 문서로 직접 시험해 보기를 권합니다.
실무자가 알아 둘 주의사항이 세 가지 있습니다. 첫째, 계산 정밀도를 'float16'으로 설정하면 안 됩니다. 값이 깨져 엉뚱한 숫자가 나오는데 오류 메시지조차 없어 알아채기 어렵다고 합니다. 'bfloat16'이나 'float32'를 쓰세요. 둘째, 검색용인지 분류용인지를 알려 주는 짧은 머리말(접두어)을 글에 붙여야 정확도가 올라갑니다. 셋째, 라이선스 표기가 모델 카드 안에서 겹쳐 보입니다. 상단에는 아파치 2.0이라고 적혀 있는데, 그 링크는 젬마 이용 조건 페이지로 이어지고, 하단에는 젬마 금지 사용 정책을 지키라는 문구도 있습니다. 상업 서비스에 넣으실 때는 원문을 꼭 확인하세요.
어디에 활용할 수 있을까요? 이미지와 글, 회의 녹취를 한 번에 뒤지는 사내 검색, 쇼핑몰의 상품 사진 및 설명 통합 검색, 콜센터 녹취 검색, 중복 콘텐츠 찾기에 활용할 수 있습니다. 이 모델을 쓰는 스페이스 중에는 브라우저 안에서 내 기기의 사진을 비슷한 것끼리 찾아 주는 시연장('EmbeddingGemma 2 WebGPU')도 있습니다.
2위: Jialinyyzz/Humanizer | Text Generation
“AI 티 나는 글을 사람 글처럼 고쳐 쓴다…내 컴퓨터에서 도는 120억 파라미터 윤문기”
허깅페이스 이용자 jialinyyzz가 구글의 젬마 4(12B)를 미세조정해 공개한 문장 다듬기 모델입니다. '좋아요'는 1천5000개 남짓, 월 다운로드는 5만4000회 안팎입니다. 이름 그대로 '휴머나이저'입니다. AI가 쓴 초안을 사람이 쓴 글처럼 읽히게 고쳐 쓰는 것이 일입니다.
이 모델은 이메일, 에세이, 보고서, 게시판 글을 다룹니다. 지원 언어는 영어와 중국어이고 한국어는 언급이 없습니다. 개발자는 모든 숫자, 단위, 날짜, 이름, 인용문은 그대로 두고 내용을 새로 지어내지 않도록 훈련했다고 설명합니다. 내 컴퓨터에서 직접 돌리는 방식이라 맥(애플 실리콘)과 윈도용 앱이 따로 나와 있고, 한 번 내려받으면 인터넷 없이도 작동합니다. 파일 크기는 가장 작은 2비트판이 3.9GB, 권장판이 12.7GB로, 메모리 8GB급 기기에서 쓸 수 있는 판까지 마련됐습니다. 회사 기밀 초안을 바깥 서비스에 올리기 꺼려진다면 솔깃한 대목입니다.
Jialinyyzz의 Humanizer의 성적입니다. 영어 초안 210건을 다시 쓴 뒤 AI 판별 서비스(Originality.ai)를 가장 엄격한 설정으로 돌렸더니 11건만 AI 글로 판정되어 95%가 사람 글로 통과했고, 이전 버전은 26건이었다고 합니다. 또 AI 심사관이 420건을 검사했더니 376건에서 사실 오류가 없었다고 합니다. 개발자는 판별기를 훈련에 쓰지 않았다고도 밝혔습니다. 다만 모두 개발자가 직접 잰 값입니다. 개발자 스스로 판별기의 결과는 시간이 지나면 달라지므로 이 값은 '특정 날짜의 한 번의 측정'일 뿐이라고 적었습니다.
이 모델 카드가 언급한 한계 목록인데요. 사실 오류가 있다고 지적된 44건 중 대부분은 단어나 구절 하나 수준이지만, 숫자, 날짜, 이름은 사용자가 직접 확인해야 한다고 당부합니다. 중국어는 영어보다 아직 부족하고, 표나 제목 같은 서식이 사라지는 경우가 420건 중 28건 있었으며, 가끔 영어 초안에 중국어로 답하거나 원문에 없던 속어를 넣는다고 합니다. 마지막 줄은 '이 도구는 내 초안을 위한 것이며, 학교, 직장, 매체에 AI 사용 규정이 있다면 따르라'는 당부입니다.
활용처는 영어 이메일과 보고서 초안 다듬기, 번역투 문장 정리, 판에 박힌 문체 풀기입니다. 이 모델을 둘러싼 법과 윤리의 쟁점은 시사점에서 따로 짚겠습니다.
3위: Qwen/Qwen-Image-2.1-Turbo | Text-to-Image
“그림이 여덟 걸음에 완성된다…70억 파라미터 이미지 모델의 가속판”
중국 알리바바 계열 큐원(Qwen) 팀이 공개한 이미지 생성, 편집 모델입니다. '좋아요'는 7백개 남짓, 월 다운로드는 1만회 안팎입니다. 기본 모델 '큐원-이미지-2.1'을 빠르게 만든 가속판이고, 70억 파라미터의 구조는 같습니다.
핵심은 '8단계'입니다. 이미지 생성 AI는 흐릿한 노이즈 화면에서 시작해 여러 번 닦아 내며 그림을 선명하게 만듭니다. 안개 낀 유리창을 몇 번 닦느냐의 문제인데, 이 모델은 단 8번의 닦기로 마무리하도록 만들어졌다고 합니다. 닦는 횟수가 줄면 그만큼 시간과 전기를 아낄 수 있습니다. 모델 카드가 보여 주는 솜씨는 만만치 않습니다. 글자가 빽빽한 교육용 포스터, 투명 배경 이미지, 화면 설계(UI) 시안, 여러 장의 참고 이미지를 합친 합성, 스케치를 실사 사진으로 바꾸는 편집이 시연 목록에 올라 있습니다. 정사각형은 2048×2048, 가로형은 최대 2752×1536까지 해상도 틀을 제공합니다.
그러나 기업 담당자에게 가장 중요한 한 줄은 성능이 아니라 라이선스입니다. 이 모델은 아파치 같은 자유 이용 조건이 아니라 '큐원 연구용 라이선스(qwen-research)'를 씁니다. 약관을 확인해 보니 연구나 평가 목적의 비상업적 이용만 허용되고, 상업적으로 쓰려면 별도 라이선스를 받아야 합니다. 이 모델로 만든 모델을 배포하면 'Built with Qwen' 표기도 해야 하고, 분쟁은 중국 항저우 법원의 관할이라는 조항이 있습니다. 법률 자문은 아니니 도입 전에 법무팀 확인을 권합니다.
흥미로운 점은 이 모델을 중심으로 파생된 생태계입니다. 이 모델을 가볍게 줄인 양자화 모델이 40종, 미세조정 모델이 13종, 이를 쓰는 스페이스가 23곳이고, 같은 주 트렌딩 목록에는 제한 장치를 풀었다는 이름의 파생 모델도 올라 있습니다. 그중 하나는 월 다운로드가 225만 회로, 원본 터보보다 100배를 훌쩍 넘습니다. 원본의 안전 장치를 풀어 다시 배포하는 일이 이렇게 빨리 퍼진다는 사실은 공개 모델의 책임을 누가 지느냐는 질문을 새삼 던집니다.
어디에 활용할 수 있을까요? 광고 시안과 상품 이미지 제작, 포스터와 카드뉴스 초안, 스케치를 사진으로 바꾸는 시각화입니다. 데모 코드는 엔비디아 GPU(CUDA) 기준이고 최신 디퓨저스(Diffusers) 소스 설치가 필요하니, 직접 돌리려면 개발자의 도움이 필요합니다. 결과물의 상업적 사용은 라이선스를 확인해야 합니다.
AI 응용프로그램(Spaces) 톱3
허깅페이스 스페이스는 AI 모델을 웹 브라우저에서 바로 체험할 수 있는 플레이그라운드입니다. 코드 한 줄 없이 최신 AI 기술을 만져볼 수 있죠. 이번 주 세 자리는 '그리는 AI', '연습하는 AI', '말하는 AI'로 정리됩니다. 아래 설명은 각 스페이스 소개문과 관련 모델 카드를 근거로 했습니다.
1위: Qwen-Image-2.1-Turbo | Hugging-apps
“한 줄 주문과 사진 열 장으로 그림을 뚝딱…터보 이미지 모델 체험장”
앞서 소개한 3위 모델을 바로 체험하는 시연장입니다. 원하는 그림을 글로 설명하고, 원한다면 고칠 사진을 최대 10장까지 올리면 그 사진을 참고해 새 그림을 만들어 줍니다. 8단계 생성과 이미지 편집을 모두 지원하고, 무료 GPU 등급(ZeroGPU)에서 돌아가며 AI 비서가 도구로 불러 쓸 수 있는 MCP 표시도 붙어 있습니다. 허깅페이스가 직접 추천한 '주목(Featured)' 스페이스이기도 합니다.
이 스페이스는 활용도가 넓은데요. 상품 사진의 배경을 바꾼 시안, 행사 포스터 초안, 사진 여러 장을 한 장면으로 합친 광고 콘셉트 시안이 대표적입니다. 다만 무료 GPU(ZeroGPU) 등급이라 사람이 몰리면 기다려야 할 수 있습니다. 또 체험은 부담이 없지만, 만든 그림을 사업에 쓰려면, 앞서 짚은 라이선스 조건부터 확인해야 합니다.
2위: RL Environments on Hugging Face | FineEnvs
“AI 에이전트가 연습하는 체육관 안내도…강화학습 환경 탐색기”
'강화학습(RL)'은 AI가 시행착오를 거치며 보상을 많이 받는 방향으로 배우는 방법입니다. 자전거를 넘어지며 배우듯, 잘하면 점수를 주고 못하면 깎는 식으로 가르칩니다. 이 스페이스는 허브에 올라온 강화학습 '환경', 즉 AI가 연습하는 체육관을 찾아 주는 검색 도구입니다. 소개문에 따르면 이름이나 키워드로 환경과 과제를 찾고, 보상 같은 세부 정보를 확인하며, 지원되는 환경에서는 에이전트가 실제로 과제를 수행해 보는 '롤아웃'도 돌려 볼 수 있다고 합니다. 같은 팀의 자매 스페이스('The ultimate guide to multi-harness RL')는 실제 에이전트 틀 안에서 공개 모델을 강화학습으로 훈련하는 방법을 안내합니다.
왜 눈여겨봐야 할까요? 요즘 AI의 화두는 '에이전트', 즉 스스로 도구를 쓰며 일을 처리하는 AI인데, 에이전트를 잘 키우려면 좋은 연습장이 필요합니다. 모델이 아무리 좋아도 연습할 환경이 부실하면 실전에서 헤맵니다. 이 도구는 그 연습장을 한곳에서 찾아보는 '체육관 안내도' 역할을 합니다. 에이전트 개발팀의 훈련, 평가 환경 탐색, 대학과 연구소의 강의 자료로 쓸 만합니다. 다만 이 글은 스페이스 소개문에 근거했고, 환경별 실행 화면은 직접 확인하지 못했습니다.
3위: Paradee | Sahilmahendrakar
“82M에서 8M으로…크기를 10분의 1로 줄인 영어 음성 합성기”
Sahilmahendrakar라는 계정이 만든 영어 음성 합성(TTS) 스페이스입니다. 소개문에 따르면 8200만 파라미터의 '코코로(Kokoro-82M)' 모델에서 '증류'해 800만 파라미터로 줄였습니다. 증류는 덩치 큰 선생님 모델의 답을 작은 학생 모델이 보고 배우는 방법입니다. 지난주 칼럼에서 '출력으로 배우기'라고 소개한 바로 그 방식이, 이번에는 음성에서 쓰인 셈입니다. 참고로 원조 코코로는 아파치 2.0으로 공개된 가벼운 음성 모델이며, 2025년 1월 v1.0이 나왔습니다.
사용법은 간단합니다. 영어 문장을 2000자까지 적고 말하는 속도를 고르면, 24kHz의 또렷한 음성 파일로 읽어 주고 발음 기호(음소) 표시도 함께 보여 줍니다. MCP 표시도 붙어 있어 AI 비서가 도구로 쓸 수 있습니다. 크기가 작으면 스마트폰 앱, 가전, 차량 음성 안내처럼 서버 없이 기기 안에서 말해야 하는 곳에 어울립니다. 앱의 읽어 주기 기능이나 영어 내레이션 시제품을 만들 때 가볍게 써 볼 만합니다. 다만 영어 전용이라 한국어는 아직 안 됩니다. 이 스페이스 자체의 이용 조건은 확인하지 못했으니 상업적으로 쓰시려면 개발자 저장소의 라이선스를 먼저 확인하기 바랍니다.
시사점 & 인사이트
이번 주 트렌드를 한마디로 요약하면 '작지만 넓고 빠른 AI'입니다.
첫째, 작은 모델이 오감을 얻고 있다.
7억4000만 파라미터 모델이 글, 사진, 영상, 소리를 한꺼번에 다루고, 800만 파라미터 모델이 말을 하며, 70억 파라미터 모델이 여덟 걸음에 그림을 그립니다. 이번 주 목록에는 큰 모델 대신 '작고 빠른 모델'이 줄줄이 올랐습니다. 중요한 변화는 이 모델들이 내 컴퓨터나 스마트폰에서 돌아갈 수 있다는 점입니다. 휴머나이저가 인터넷 없이 돌아가고, 임베딩젬마 2가 일반 기기를 염두에 둔 것처럼, 민감한 문서가 회사 밖으로 나가지 않는 AI 도입이 현실적인 선택지가 되고 있습니다. 실무 권고는 하나입니다. 새 AI 서비스를 기획할 때 거대 모델부터 가정하지 말고, 작은 모델로 먼저 시제품을 만들어 보세요. 비용도, 보안 부담도 크게 달라집니다.
둘째, 검색의 단위가 '글'에서 '자료'로 바뀐다.
임베딩젬마 2의 등장은 사내 검색 설계의 전제를 흔듭니다. 지금까지 기업의 검색 AI는 대부분 글만 뒤졌습니다. 그런데 회사의 지식은 슬라이드 속 도표, 현장 사진, 회의 녹음, 교육 영상에도 담겨 있습니다. 이것들을 한 주소록에 넣을 수 있다면, "지난달 그 회의에서 나온 설비 사진"을 찾는 일이 가능해집니다. 저장 비용 걱정도 줄었습니다. 토막상식에서 다룰 '마트료시카 임베딩' 덕분에 좌표를 잘라 쓸 수 있기 때문입니다. 다만 멀티모달의 한국어 성능은 확인되지 않았으니, 우리 자료로 소규모 시험부터 하세요.
셋째, 다운로드 숫자보다 라이선스 한 줄이 기술 선택을 좌우한다.
이번 주 세 모델은 라이선스가 제각각입니다. 임베딩젬마 2는 아파치 2.0으로 표기됐지만 카드 안에 젬마 정책 링크가 섞여 있고, 휴머나이저는 아파치 2.0이며, 큐원 터보는 연구용입니다. 그런데 정작 이용자들은 큐원 터보의 제한 해제 파생판을 원본의 100배 넘게 내려받고 있습니다. 인기가 사용 허락을 의미하지는 않습니다. 주의하실 점은 모델을 고를 때 성능표 옆에 '라이선스 확인란'을 만들고, 상업 이용 여부, 표기 의무, 분쟁 관할을 체크 항목으로 삼으세요. 성능은 한 달 뒤 더 나은 모델이 나오면 바꿀 수 있지만, 약관 위반의 책임은 되돌릴 수 없습니다.
넷째, 'AI 티 안 나는 글'의 시대, 표시와 책임의 문제.
휴머나이저의 인기는 시대의 단면을 보여 줍니다. AI로 초안을 쓰고, 다른 AI로 사람 글처럼 고쳐 쓰고, 또 다른 AI 판별기로 검사하는 삼각 구도입니다. 이 군비 경쟁의 승부는 아무도 장담하지 못합니다. 개발자 스스로 판별기 결과는 '특정 날짜의 한 번의 측정'이라고 선을 그었습니다.
여기에 우리나라 제도를 살펴볼 필요가 있습니다. 우리나라 AI 기본법은 2026년 1월 22일 시행됐고, 생성형 AI가 만든 글, 이미지, 영상 등에는 AI가 만들었다는 표시를 하도록 요구합니다. 눈에 보이는 워터마크나 기계가 읽는 메타데이터 방식이 모두 인정되고, 과태료 규정이 있지만 1년 이상의 계도기간이 예정돼 실제 부과는 2027년 이후가 될 전망입니다. 이 의무는 생성형 AI를 서비스로 제공하는 사업자가 일차적인 대상으로 알려져 있어, 윤문 도구를 업무에 쓰는 일반 기업이나 개인에게 곧바로 적용되는지는 별개의 문제입니다. 그러나 법과 별개로, 회사 규정, 거래처 계약, 학교와 매체의 정책은 따로 있습니다. 권고는 간단합니다. 조직마다 'AI를 어디까지 쓰고, 어떻게 밝힐 것인가'를 먼저 정해 두십시오. 도구가 아무리 정교해져도, 그 글에 대한 책임은 결국 이름을 올린 사람에게 돌아옵니다. 구체적인 법 적용은 반드시 법제처 원문이나 전문가를 통해 확인하기 바랍니다.
토막상식 : 임베딩과 마트료시카, 의미를 숫자 좌표로 바꾸는 법
이번 주 1위 모델을 제대로 읽으려면 '임베딩'과 '마트료시카 임베딩'을 알아야 합니다.
임베딩은 글, 사진, 소리의 '뜻'을 좌표로 바꾸는 일입니다. 지도 앱에서 서울 시청의 위치를 '위도, 경도'로 표시하듯, AI는 "오늘 날씨가 좋네요"라는 문장을 768개의 숫자 묶음으로 바꿉니다. 이 숫자 묶음이 '벡터'이고, 숫자의 개수가 '차원'입니다. "날씨가 화창하다"와 "햇살이 좋다"는 좌표가 가깝고, "그는 경기장으로 차를 몰았다"는 멀리 떨어집니다. 검색은 결국 "내 질문의 좌표와 가장 가까운 자료"를 찾는 일이 됩니다.
문제는 저장 공간입니다. 문서가 1억건이고 한 건당 768개의 숫자를 4바이트씩 저장한다고 하면, 1억X768X4바이트로 약 307GB가 필요합니다. 계산 예시이며 실제 저장 방식에 따라 달라집니다. 여기서 등장하는 것이 러시아 전통 인형 '마트료시카'를 닮은 기술입니다. 큰 인형 안에 작은 인형이 들어 있듯, 앞쪽 일부 숫자만 잘라 써도 뜻이 최대한 유지되도록 훈련하는 방식입니다. 임베딩젬마 2는 768개를 512개, 256개, 128개로 잘라 쓸 수 있습니다. 위 예시에서 256개로 줄이면 약 102GB로, 저장 비용이 3분의 1로 줄어듭니다. 모델 카드에 따르면 256개까지는 품질 손실이 크지 않지만, 128개로 줄이면 사진과 소리를 함께 다룰 때 품질이 눈에 띄게 떨어집니다. 128개는 글만 다룰 때 적합하다고 합니다.
초보자들이 기억할 대목은 하나입니다. 임베딩은 '뜻의 좌표'이고, 좌표를 잘라 쓰면 싸지만 어디까지 잘라도 괜찮은지는 우리 자료로 직접 재 봐야 합니다. 그리고 잘라 쓴 뒤에는 길이를 다시 맞추는 '정규화'를 잊지 마세요. 그 단계를 빼먹으면 오류도 없이 검색 순위만 슬며시 나빠진다고 모델 카드가 경고합니다.
마무리
이번 주 허깅페이스를 한 문장으로 요약하면 이렇습니다. "작은 AI가 오감을 얻고, 문장을 고쳐 쓰고, 여덟 걸음에 그림을 그렸다."
구글의 임베딩 모델은 글, 사진, 영상, 소리를 하나의 주소록에 정리했습니다. 한 개발자는 AI 초안을 사람 글처럼 고쳐 쓰는 모델을 내 컴퓨터 안에 넣었고, 큐원은 여덟 번의 계산으로 그림을 완성하는 이미지 모델을 내놓았습니다. 스페이스에서는 그림 체험장, 에이전트 연습장 안내도, 800만 파라미터 음성 합성기가 나란히 자리를 채웠습니다.
마지막으로 속담 하나를 덧붙입니다. '작은 고추가 맵다'는 말은 AI 업계에서 한동안 '대마불사'라는 믿음에 밀려 있었습니다. 그런데 이번 주 목록은 속담이 돌아왔다고 말하는 듯합니다. 다만 고추가 매운 것과 아무 데나 넣어도 되는 것은 다른 이야기입니다. 라이선스라는 레시피를 확인하지 않으면 맛있는 요리가 탈이 나는 법입니다.
다음 주에는 또 어떤 모델이 허깅페이스 정상을 차지할까요. 임베딩젬마 2가 한국어 자료에서는 어떤 성적을 낼지, 작은 음성 합성기가 한국어를 배울지, 그리고 AI 기본법의 표시 의무가 구체적으로 어떻게 정리될지 지켜봐 주기 바랍니다.
※ 외부필자의 원고는 IT조선의 편집방향과 일치하지 않을 수 있습니다.
정원훈 텐에이아이 대표는 명지대학교 AI콘텐츠창작학과 겸임교수이자 한국인공지능경영협회 이사, 한국지식재산교육연구학회 이사 겸 기술가치평가위원장과 한국벤처창업학회 이사로 활동하고 있다. 법률 AI 서비스 ‘서울로봇’과 블록체인 기반 ESG 프로젝트 ‘BlockESG’를 총괄했고, 장성군 RE100 산업단지 및 AI 데이터센터 조성 타당성 분석 컨설팅을 수행했다. 아시아경제신문 뉴미디어본부 차장과 매경인터넷 금융센터 팀장을 거쳤으며, SNS 플랫폼 개발, 대안신용평가 시스템 구축, AI 기반 법률 서비스 등 IT·금융·인공지능을 융합한 혁신 프로젝트를 주도해 온 전문가다.